Как рассчитать серверы HPE для виртуализации и отказоустойчивого кластера
Сервер для виртуализации рассчитывают по пиковому потреблению виртуальных машин, требованиям к доступности и ресурсам, которые останутся после отказа узла. Сумма выделенных vCPU показывает конфигурацию гостей, но не равна числу физических ядер, которое необходимо купить. Для отказоустойчивого кластера сначала задают сценарий отказа, затем проверяют CPU, RAM, хранение и сеть в этом сценарии.
Что собрать о виртуальных машинах до заказа серверов
Составьте ведомость ВМ: назначение, операционная система, vCPU, выделенная и фактически используемая память, размер дисков, профиль ввода-вывода, сетевой поток и допустимый простой. Для каждой машины отметьте, является ли она постоянной, временной или выключенной большую часть времени. Тестовая ВМ и производственная база требуют разных правил размещения.
Загрузку измеряют за полный рабочий цикл. Если бухгалтерская система нагружена в конце месяца, средний CPU за спокойную неделю создаст слишком оптимистичную картину. Для каждой группы сохраните рабочий пик, продолжительность пика и совпадение его с другими задачами. Сумма независимых максимумов бывает избыточной, а сумма средних значений — недостаточной.
Отдельно запишите рост и задачи обслуживания: новые ВМ, обновления, антивирусное сканирование, резервное копирование, репликация и миграция. Эти процессы используют те же CPU, диски и сеть. Время их выполнения можно развести, но это должно быть частью проекта, а не надеждой на отсутствие совпадений.
| Группа ВМ | Данные для расчёта | Что легко пропустить |
|---|---|---|
| СУБД и ERP | Пиковая CPU-нагрузка, рабочий набор RAM, задержка дисков | Фоновые задания и рост базы |
| Терминальные серверы | Одновременные сеансы, память приложений | Браузеры и печать внутри сеанса |
| Файловые сервисы | Объём, поток и случайные обращения | Антивирус и резервное копирование |
| Инфраструктура | DNS, каталог, мониторинг, управление | Зависимость запуска других сервисов |
| Тестовые ВМ | Расписание, лимиты и приоритет | Неконтролируемый рост снимков |
Почему vCPU нельзя считать как физические ядра
vCPU — виртуальный процессор гостевой системы. Несколько vCPU разных машин могут пользоваться временем одного физического ядра, если их задачи не выполняются постоянно и одновременно. Но это не означает, что можно назначить произвольное количество vCPU без последствий. При дефиците ресурсов гостевые машины ждут доступа к CPU, даже когда средняя диаграмма выглядит приемлемой.
Не назначайте большой ВМ максимальное число vCPU просто ради запаса. Избыточная ширина виртуального процессора усложняет размещение и иногда ухудшает поведение приложения. Начальная конфигурация должна соответствовать измеренной параллельности; увеличение подтверждается тестом. Для CPU-насыщенной нагрузки коэффициент переподписки будет отличаться от коэффициента для лёгких инфраструктурных сервисов.
Сравнение серверов по ядрам имеет смысл только вместе с производительностью конкретного поколения CPU. Тридцать два старых и тридцать два новых ядра не дают автоматически одинаковую вычислительную ёмкость. При обновлении кластера полезен одинаковый нагрузочный сценарий, который измеряет результат приложения, а не только характеристики процессора.
Как рассчитать RAM без опасного резерва на бумаге
Память — один из главных ограничителей плотности виртуализации. Гостям нужен рабочий объём, гипервизору — собственные ресурсы, а некоторым подсистемам хранения — дополнительный кэш. Ballooning, дедупликация или сжатие памяти не должны быть единственным условием выживания важных ВМ после отказа узла. Обсуждать эти механизмы нужно отдельно для выбранной платформы и приложения.
Рассмотрим учебный кластер из трёх одинаковых узлов по 256 ГиБ RAM. На каждый узел резервируем 16 ГиБ для гипервизора и системных служб. В сценарии отказа одного узла остаётся 2 × (256 − 16) = 480 ГиБ. Если из доступного объёма оставить 20% резерва роста и пиков, бюджет производственных ВМ составит 480 × 0,8 = 384 ГиБ.
Если ведомость ВМ требует 320 ГиБ, она укладывается в этот расчёт с дополнительными 64 ГиБ до выбранного порога. Если требуется 420 ГиБ, система может поместиться физически, но уже нарушит заданный резерв. Для проекта с обслуживанием одного узла и одновременным отказом другого нужен более строгий сценарий: после двух недоступных узлов остаётся один, и прежний расчёт больше не подходит.
Не путайте установленную память и доступную память. В смете обычно используются привычные обозначения «ГБ», а в измерениях ОС — двоичные единицы. Для сравнения выберите одну систему единиц и придерживайтесь её во всей таблице.
Что означает N+1 и когда этого недостаточно
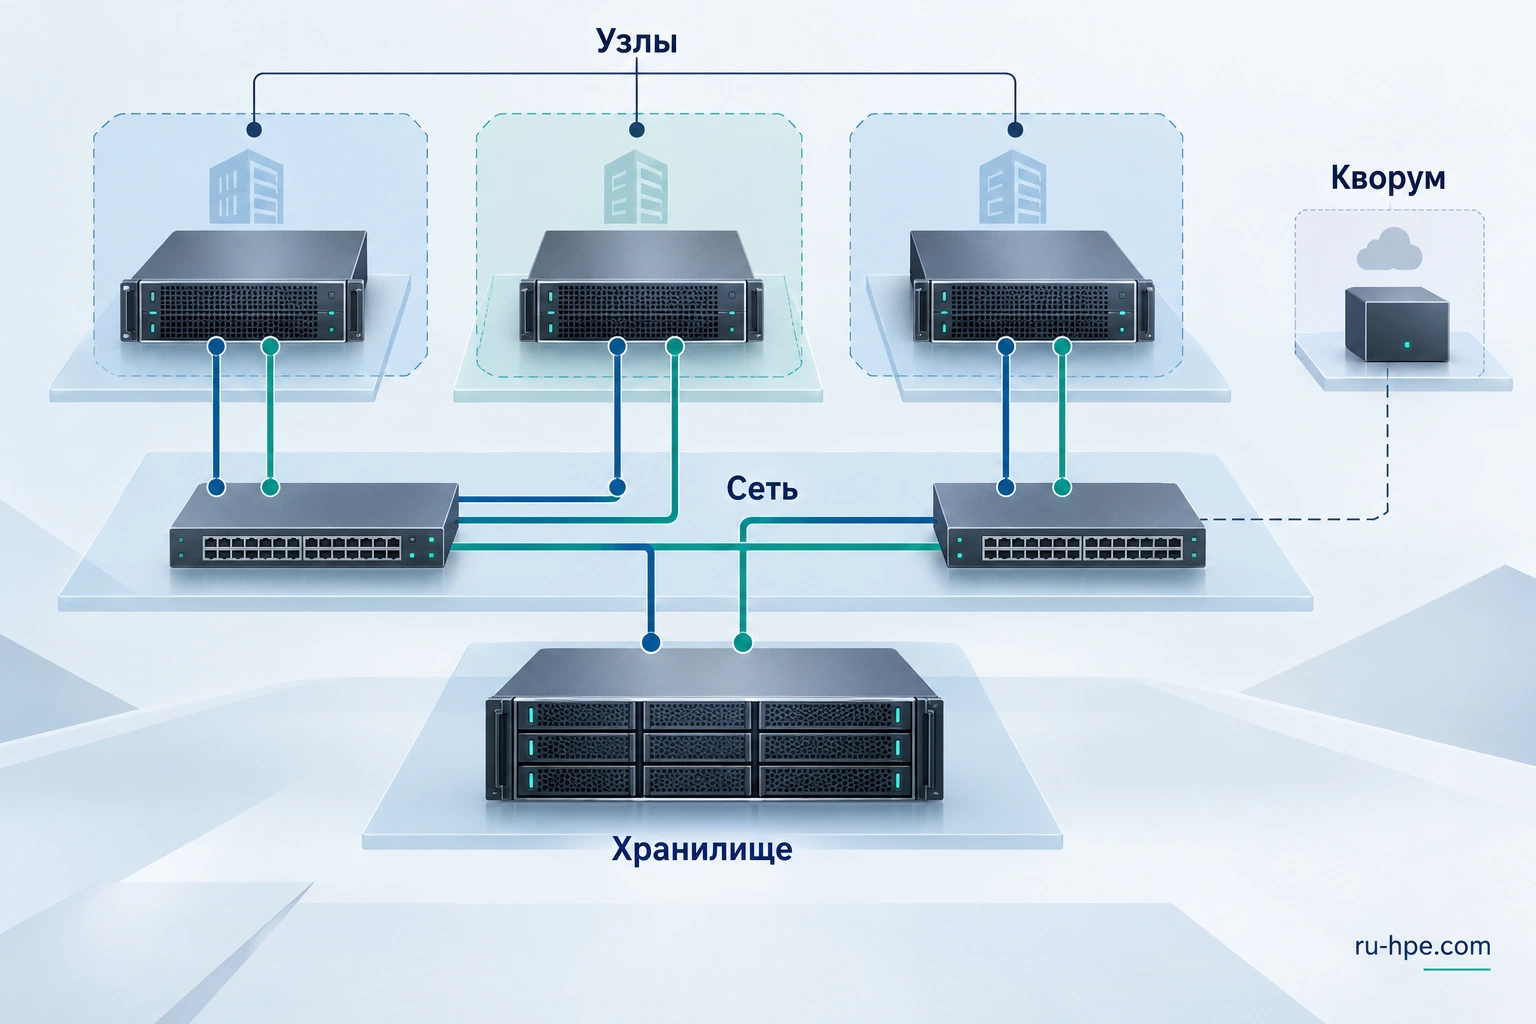
N+1 означает наличие ресурса для предусмотренной нагрузки при потере одного узла. Оно не является универсальной гарантией непрерывной работы. Нужно проверить, какие ВМ перезапускаются, за какое время, куда они помещаются и доступны ли им данные. Если хранилище или сеть остаются единственной точкой отказа, третий сервер не решает эту проблему.
Плановое обслуживание тоже уменьшает доступные ресурсы. Обновление гипервизора, BIOS или оборудования желательно проводить без нарушения согласованных условий. Для важных систем заранее определите, допускается ли обслуживание в режиме временного снижения отказоустойчивости либо нужен запас на второй отказ.
Достаточно ли двух узлов для кластера?
Двухузловая схема возможна в определённых архитектурах, но требует решения вопросов кворума, разделения сети и хранения. Третий голос или witness помогает принимать решение кластера, однако сам по себе не добавляет вычислительную ёмкость и не создаёт третью копию данных. Его роль нельзя путать с ролью полноценного узла.
Выбирать локальное хранение, SAN или распределённую систему?
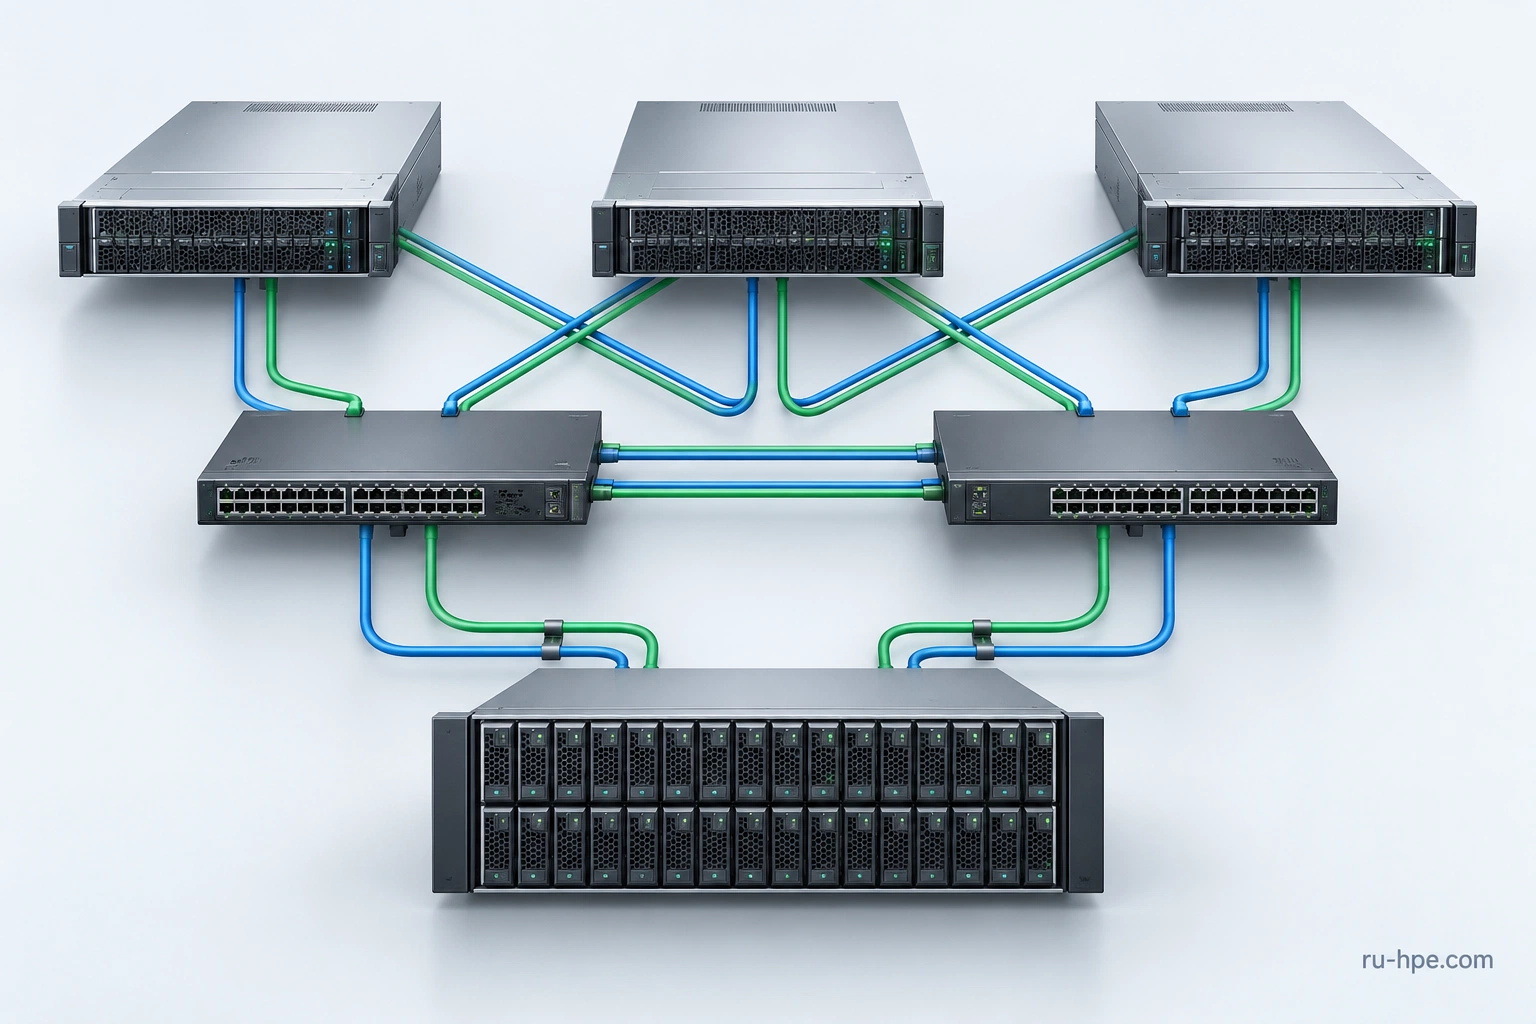
Обычный локальный диск одного узла не доступен другому узлу после его физического отказа. Чтобы ВМ могла запуститься в другом месте, нужен предусмотренный механизм общего хранения, репликации или распределённой системы. У каждого варианта свои ограничения по времени восстановления, потере последних изменений и сетевой нагрузке.
Общая СХД отделяет вычислительные узлы от хранения, но сама требует резервирования контроллеров и путей доступа. Распределённое хранение переносит работу с данными на кластерные узлы и сеть; его ёмкость считают после учёта копий либо схемы кодирования. Например, при трёх полноценных копиях 30 ТБ сырого объёма дают 10 ТБ до служебного резерва. Это арифметика выбранного режима, а не паспорт любой распределённой системы.
Для Proxmox с ZFS контроллер должен предоставлять диски способом, совместимым с управлением ZFS. Нельзя бездумно помещать ZFS поверх аппаратного RAID с независимым управлением кэшем. Проверяют режим HBA, представление дисков, защиту питания и выбранную архитектуру. Конфигурация, подходящая для одного гипервизора, не обязана быть оптимальной для другого.
Варианты общего хранения можно сравнить в разделе систем хранения данных. Требования к полезной ёмкости, задержке и отказам задайте раньше, чем выбирать название массива.
Какую сеть заложить для ВМ, миграции и резервных копий
Разделите назначение потоков: управление, пользовательский трафик, миграция, хранение и бэкапы. Разделение может быть физическим или логическим, но ресурсы канала при логическом разделении продолжают быть общими. VLAN разграничивает трафик; он не увеличивает пропускную способность порта.
Пример оценки времени: перенос 200 ГБ по каналу 10 Гбит/с имеет идеальную нижнюю границу около 160 секунд, поскольку 10 Гбит/с соответствуют 1,25 ГБ/с до накладных расходов. Реальный процесс зависит от протокола, активности ВМ, CPU и фактической скорости. Если одновременно идут резервные копии, время изменится. На 1 Гбит/с та же идеальная нижняя граница составляет около 1600 секунд.
Проверьте резервирование на двух независимых коммутаторах и согласованный режим адаптеров. Два кабеля в один коммутатор защищают от части отказов линии, но оставляют общий риск самого устройства. Оптика, DAC и сетевые карты должны быть совместимы с обоими концами соединения. Для выбора используйте коммутаторы HPE и подходящие сетевые трансиверы.
Пример проверки трёхузловой конфигурации
Учебный проект состоит из трёх узлов с одинаковой производительностью CPU и 256 ГиБ RAM на каждом. Суммарное требование ВМ по памяти — 320 ГиБ; резерв гипервизора — 16 ГиБ на узел. Требования по CPU подтверждаются испытанием, а не суммой vCPU. СХД и сеть проверяются в сценарии недоступности одного пути или контроллера.
| Проверка | Сценарий | Условие приёмки |
|---|---|---|
| Память | Один узел недоступен | ВМ помещаются в бюджет 384 ГиБ при выбранном резерве |
| CPU | Критичные ВМ на двух узлах | Рабочие операции выполняются за согласованное время |
| Сеть | Один коммутатор или линк недоступен | Оставшиеся пути обеспечивают согласованный сервис |
| Хранение | Отказ одного предусмотренного компонента | Данные доступны, ошибки приложения не выходят за условия проекта |
| Восстановление | Остановка физического узла | Согласованное время перезапуска и запуска приложений |
| Бэкап | Восстановление отдельной ВМ | Система запускается и данные проходят проверку |
Такая таблица превращает обещание «кластер с HA» в проверяемый результат. Если приложение требует непрерывного выполнения без перезапуска, одного HA гипервизора недостаточно: архитектуру доступности нужно строить на уровне приложения и данных.
NUMA, поколения CPU и совместимость миграции
Большой виртуальной машине может понадобиться больше памяти и CPU, чем помещается в один NUMA-узел. Размещение нужно согласовать с гипервизором и особенностями приложения. Равномерная установка памяти по процессорам уменьшает риск создания перекоса, когда один CPU обслуживает память другого.
Совместимость миграции проверяется по конкретным процессорам, режимам CPU гостя, версиям гипервизора и драйверам. Наличие одинакового бренда сервера не гарантирует одинаковый набор процессорных возможностей. При смешении поколений заранее протестируйте перенос наиболее требовательных ВМ и периферии. GPU passthrough и другие закреплённые устройства могут менять доступность обычной миграции.
При выборе платформы учитывайте PCIe-слоты, сетевые адаптеры, дисковые отсеки, охлаждение и доступные наборы расширения. Подходящие узлы можно начать сравнивать в каталоге серверов, но окончательную спецификацию сверяют по всем компонентам.
Лицензии и обслуживание нужно считать вместе с железом
Составьте отдельную ведомость: гипервизор, ОС гостей, СУБД, резервное копирование, управление и техническая поддержка. Права использования могут зависеть от ядер, сокетов, виртуальных машин, пользователей и условий перемещения. Их проверяют для актуальных редакций и конкретного договора; перенос правил одной системы на другую приводит к ошибкам.
В расчёт эксплуатационных затрат включите питание, размещение, резервные детали, время администратора и обслуживание. Сравнивайте одинаковую доступность: дешёвый одиночный сервер и кластер с резервными путями — разные решения. Для выбора полезно запросить две конфигурации на одно техническое задание, а не сравнивать только цену корпуса.
Как проверить готовый кластер
До размещения рабочих данных выполните контролируемые испытания: миграция ВМ, перезапуск после остановки узла, потеря предусмотренного сетевого пути, восстановление бэкапа и возврат узла в кластер. Опишите границы каждого теста и порядок восстановления, чтобы испытание не превратилось в неконтролируемый простой.
Сохраните конфигурации, версии прошивок, драйверов и ПО, показатели нагрузки и фактическое время восстановления. Проверка должна включать прикладной сервис внутри ВМ: доступный виртуальный диск ещё не означает, что база данных и приложение работают корректно. Наиболее ценный документ приёмки — протокол выполнения согласованных сценариев.
N+1 по памяти выполнено, а кластер всё равно не выдерживает отказ
Резервировать нужно каждый дефицитный ресурс. Если после потери одного узла остаётся достаточно RAM, но оставшиеся процессоры постоянно загружены или хранилище не выдерживает массовую загрузку ВМ, формальный расчёт N+1 не решает задачу. Рассматривайте CPU, память, ввод-вывод и сеть в одном аварийном сценарии. Особенно важен «шторм загрузки»: несколько серверов приложений одновременно читают ОС, запускают службы и восстанавливают соединения с базами.
Учебная схема: три одинаковых узла имеют по 24 физических ядра, из которых по два зарезервированы для собственной работы и управления. После отказа остаётся 44 ядра. Если согласованная аварийная нагрузка требует эквивалент 36 полностью занятых ядер, загрузка доступной вычислительной ёмкости составляет около 81,8%. Требование оставлять 20% свободного ресурса при таком отказе не выполнено: допустимо 35,2. Это упрощённый расчёт на основе заранее заданного эквивалента нагрузки; число выделенных vCPU нельзя подставлять вместо измеренного потребления.
Проверьте не только сумму, но и возможность размещения каждой ВМ. Например, гостевая система на 300 ГиБ не поместится на узел с 240 ГиБ доступной памяти, даже если на двух узлах суммарно свободно 400 ГиБ. Ограничения сродства, закреплённые GPU, локальные диски и привязка к определённому оборудованию также мешают перераспределению. Ведомость должна показывать, какие ВМ действительно можно перезапустить на каждом оставшемся узле.
Кворум, fencing и доступность приложения — три разные проверки
Кворум определяет, какая часть кластера имеет право принимать решения. Fencing исключает опасную одновременную работу узла, который считается потерянным, и его замены. Эти механизмы защищают от ситуации, когда две стороны разделённой сети начинают независимо управлять одним ресурсом. Для Proxmox VE кворум и HA настраивают по правилам установленной версии; произвольное уменьшение числа ожидаемых голосов не является полноценным проектом отказоустойчивости.
Отдельный QDevice в подходящей двухузловой схеме добавляет голос, но не выполняет работу ВМ. Если его разместить на том же физическом сервере, отказ которого он должен помогать пережить, независимость исчезает. Путь к арбитру и питание тоже входят в карту отказов. Не путайте сетевую доступность арбитра с наличием актуальной копии данных: это разные условия восстановления.
HA гипервизора обычно означает автоматический запуск ВМ на другом узле, а не непрерывное исполнение всех её процессов без паузы. Приложению ещё нужно загрузиться, восстановить транзакции и принять подключения. Поэтому время обнаружения отказа, решение кластера, старт ОС и восстановление приложения измеряют отдельно. Если бизнес требует почти незаметного переключения, может потребоваться отказоустойчивость на уровне приложения и СУБД.
Как составить матрицу отказов для закупки
| Событие | Что должно продолжить работу | Что требуется проверить |
|---|---|---|
| Потеря одного вычислительного узла | Приоритетные ВМ на оставшихся узлах | Ресурсы, размещение, время запуска служб |
| Потеря одного коммутатора | Предусмотренные сетевые и дисковые пути | Независимость кабелей и правильность переключения |
| Потеря контроллера массива | Доступ к рабочим LUN | Multipath, задержки, отсутствие ошибок приложения |
| Разделение кластерной сети | Только разрешённая сторона продолжает управление | Кворум и fencing без двойного запуска |
| Плановое обслуживание и ещё один отказ | Согласованный набор сервисов | Отдельный расчёт, если такой режим входит в требования |
Таблица превращается в приёмочные сценарии на тестовом контуре. Для каждого события задайте точку начала, критерий восстановления и сведения, которые нужно сохранить. «ВМ снова видна в панели» недостаточно: проверяют реальную авторизацию пользователя, запрос к базе и выполнение операции. Ложное успешное переключение обнаруживается именно на прикладном уровне.
Почему увеличение vCPU иногда замедляет ВМ
Большой виртуальный процессорный комплект сложнее разместить и обеспечить физическим временем выполнения. Ненужные vCPU увеличивают конкуренцию за ресурсы; приложение может не использовать их эффективно. Начинайте с измеренного спроса и расширяйте ВМ после анализа загрузки, очередей и показателей планировщика конкретного гипервизора. Для тяжёлой ВМ полезно сравнить несколько размеров при одной и той же нагрузке, а не считать самый большой автоматически лучшим.
При NUMA важны не только vCPU, но и память. Гость, который пересекает границы физических узлов NUMA, способен чаще обращаться к удалённой RAM. Точный эффект зависит от CPU, настроек гостя и приложения. Перед закреплением ресурсов сравните обычное размещение и согласованный вариант локализации; жёсткая привязка может улучшить отдельный тест, но ухудшить возможность аварийного перераспределения.
Как заложить восстановление распределённого хранения
При потере диска или узла система должна не только обслуживать ВМ, но и восстанавливать защиту данных. Эти операции потребляют сеть, диски и CPU одновременно. Ёмкость «после трёх копий» без свободного пространства для восстановления не описывает безопасное заполнение. Зафиксируйте доступный резерв по правилам выбранной системы и проверьте, куда можно разместить недостающие копии при самом неприятном допустимом отказе.
Аварийная модель должна включать приоритеты. Система авторизации, DNS и база часто нужны раньше зависимых приложений, а тестовые машины можно временно не запускать. Такой порядок согласуют с владельцами сервисов, проверяют на стенде и включают в эксплуатационные инструкции. Это позволяет сравнивать конфигурации по реальному уровню обслуживания, а не по количеству узлов в стойке.
Частые вопросы
Можно ли назначить больше vCPU, чем физических ядер?
Да, при соответствующем профиле нагрузки и контроле ожидания CPU. Но единый коэффициент переподписки для всех ВМ некорректен. Критичные CPU-насыщенные приложения и лёгкие инфраструктурные службы должны иметь разные правила и приоритеты.
Сколько RAM нужно для двадцати виртуальных машин?
Сначала суммируют рабочие требования каждой машины, затем добавляют ресурсы гипервизора и резерв сценария отказа. Двадцать ВМ по 4 ГиБ и двадцать ВМ по 32 ГиБ — принципиально разные проекты. Число ВМ без профиля не определяет объём RAM.
Нужна ли внешняя СХД для любого кластера?
Нет. Возможны общее внешнее и распределённое хранение, а также определённые схемы репликации. Решение зависит от RPO/RTO, ресурсов сети, администратора и бюджета. Главное — обеспечить доступ к нужным данным на узле, где ВМ должна запуститься.
HA означает, что пользователи не заметят отказ?
Не обязательно. При перезапуске ВМ и приложения есть время восстановления. Непрерывность конкретного сервиса требует отдельной архитектуры. В техническом задании задайте допустимый перерыв, а в испытаниях измерьте его.
Что передать для подбора серверов HPE?
Ведомость ВМ, пиковые замеры, требования роста, сценарии отказов, ПО, сеть и хранение. Если нужен готовый проект, отправьте эти данные через подбор оборудования и запросите КП с расчётом ресурсов, составом опций и условиями приёмки.